 VPC Atlas
Una cuenta de AWS, varios entornos y los tags como único mapa
Cómo VPC Atlas dibuja y hace el inventario de un entorno de una cuenta de AWS compartida con su nuevo filtro por tag, y qué deja fuera.
Cuando la cuenta es toda la empresa
Muchos equipos no reparten su AWS en cuentas como hacen los diagramas de referencia. No lo defiendo: una cuenta por entorno es el consejo habitual. Esto es para las cuentas que ya existen. Una sola cuenta guarda prod, staging y un sandbox, y a veces varios equipos además. Lo que los distingue es un tag: Environment=prod, Team=payments. Si el etiquetado es coherente, los tags son el único mapa de qué pertenece a qué.
Eso es incómodo para una herramienta que dibuja redes. VPC Atlas toma la cuenta como unidad y dibuja lo que encuentra, región por región. En una cuenta compartida eso significa prod junto a staging junto al sandbox, en una sola página. La página crece y dice poco: preguntabas por prod y la respuesta llega mezclada con el resto. VPC Atlas también escribe una página por VPC, y eso basta cuando cada entorno tiene la suya. No basta cuando dos entornos comparten VPC, ni cuando quieres que la página de región, el inventario y el dashboard salgan reducidos también.
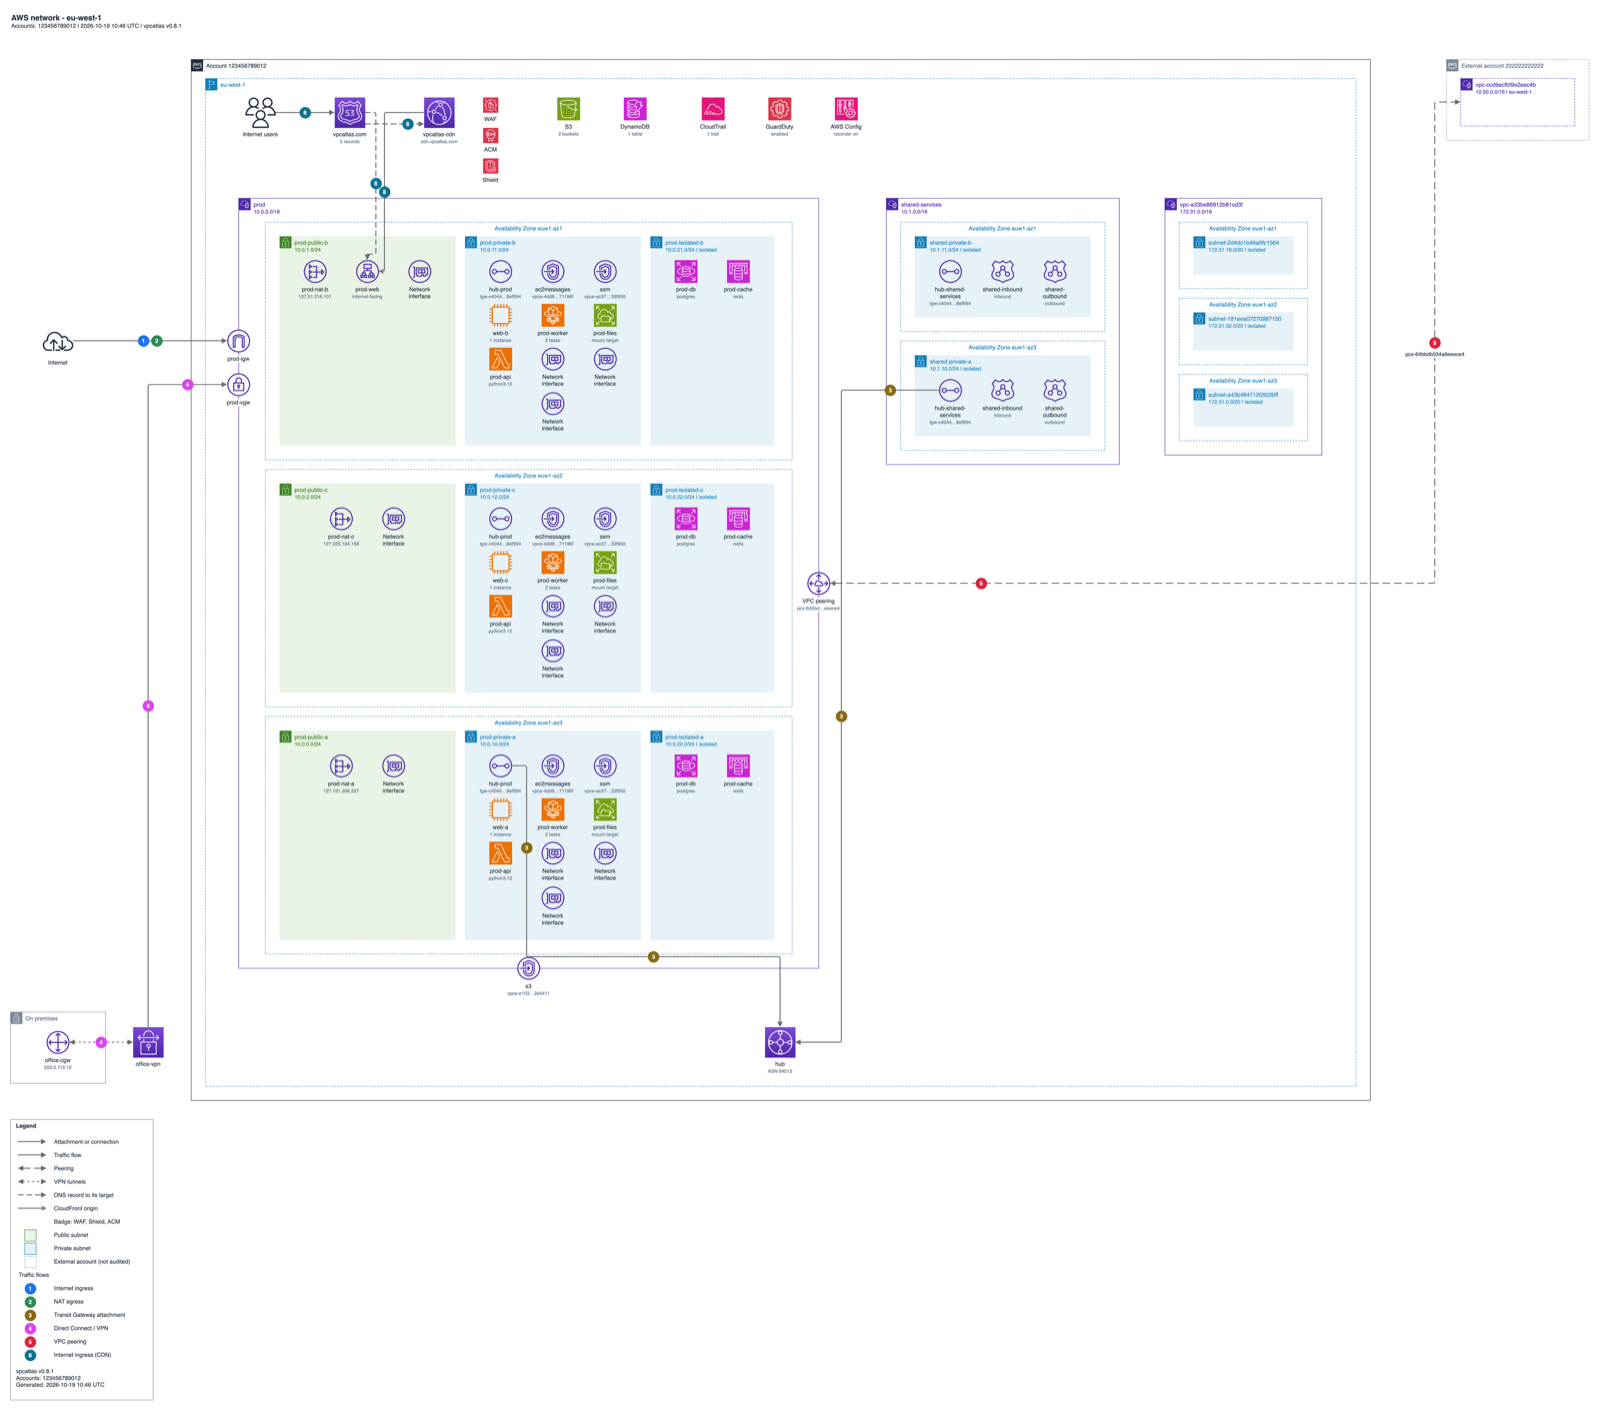
La versión 0.8.0 añade --tag. Te da el diagrama y el inventario de un entorno de una cuenta compartida, sin mover ni un solo recurso. Aquí cuento la opción, dos decisiones de diseño (una con un bug que encontré al preparar estas figuras), lo que desaparece bajo el filtro y cómo funciona con un grafo guardado y con el dashboard. La parte que yo leería dos veces es la que explica lo que desaparece. Hace falta la 0.8.1 o posterior; el motivo está en la historia de más abajo.
La opción
pipx install vpcatlas        # o: curl -fsSL https://vpcatlas.com/install.sh | sh
vpcatlas discover -r eu-west-1 --tag Environment=prod
--tag CLAVE=VALOR conserva los recursos que llevan ese tag con ese valor. --tag CLAVE conserva los que llevan el tag con cualquier valor. La opción se puede repetir, y entonces deben cumplirse todas las reglas a la vez (un AND). En el valor, * y ? son comodines. Claves y valores se comparan tal cual, mayúsculas incluidas, de modo que environment=prod no encuentra nada en una cuenta que usa Environment=prod. El valor se corta en el primer =.
Tres formas:
vpcatlas discover --tag Environment=prod --tag Team=payments
vpcatlas discover --tag 'Name=web-*'
vpcatlas discover --tag Owner
La primera es un equipo dentro de un entorno, la segunda una convención de nombres, la tercera todo lo que tiene dueño, sea cual sea. La opción funciona en discover, inventory, diagram y serve (documentación). Primero se excluyen los servicios con --exclude-services (la opción que ya existía para dejar fuera servicios enteros), y después las reglas de tag deciden qué se queda.
Lo que medí
Las cifras salen de la cuenta simulada de los artículos anteriores, en eu-west-1, creada con moto, la biblioteca de Python que imita AWS. La VPC prod (10.0.0.0/16) tiene nueve subnets en tres zonas, NAT gateways, un balanceador de carga, tres grupos de una sola instancia, endpoints, mount targets de EFS, una instancia de RDS, un clúster de ElastiCache prod-cache, una Lambda prod-api y un clúster de ECS prod con el servicio prod-worker. A su lado hay una VPC de servicios compartidos con endpoints y una regla de Route 53 Resolver, una tercera VPC, un Transit Gateway hub, una VPN a una oficina, un peering con una VPC de otra cuenta, y los servicios de edge y de cuenta (CloudFront, la hosted zone, el certificado, Shield, WAF, S3, DynamoDB, CloudTrail, Config, GuardDuty y otros).
Los tags siguen una convención: la mayoría de los recursos de prod llevan Environment=prod y los compartidos Environment=shared. El clúster de ECS prod y su servicio prod-worker, la web ACL, el hub, la VPN, el customer gateway de la oficina, las interfaces de red, las ACL de red y las listas de prefijos no llevan ningún tag Environment.
vpcatlas discover -r eu-west-1 --output-dir vpcatlas-all encuentra 100 recursos y 0 incidencias. Después, sobre el grafo guardado:
vpcatlas inventory --cache vpcatlas-all/vpcatlas-graph.json --tag Environment=prod --format csv --output-dir vpcatlas-prod
Eso escribe 34 filas de 100: 1 de 3 VPC, 9 de 14 subnets, 5 de 9 tablas de rutas, 3 de 7 security groups, los 3 grupos de instancias, los 3 NAT gateways, los 3 endpoints, y uno de cada para el balanceador, el target group, la instancia de RDS, el sistema de ficheros EFS, el internet gateway, el virtual private gateway y el peering.
El diagrama sale del mismo grafo guardado y de la misma regla:
vpcatlas diagram --cache vpcatlas-all/vpcatlas-graph.json --tag Environment=prod --output-dir vpcatlas-prod
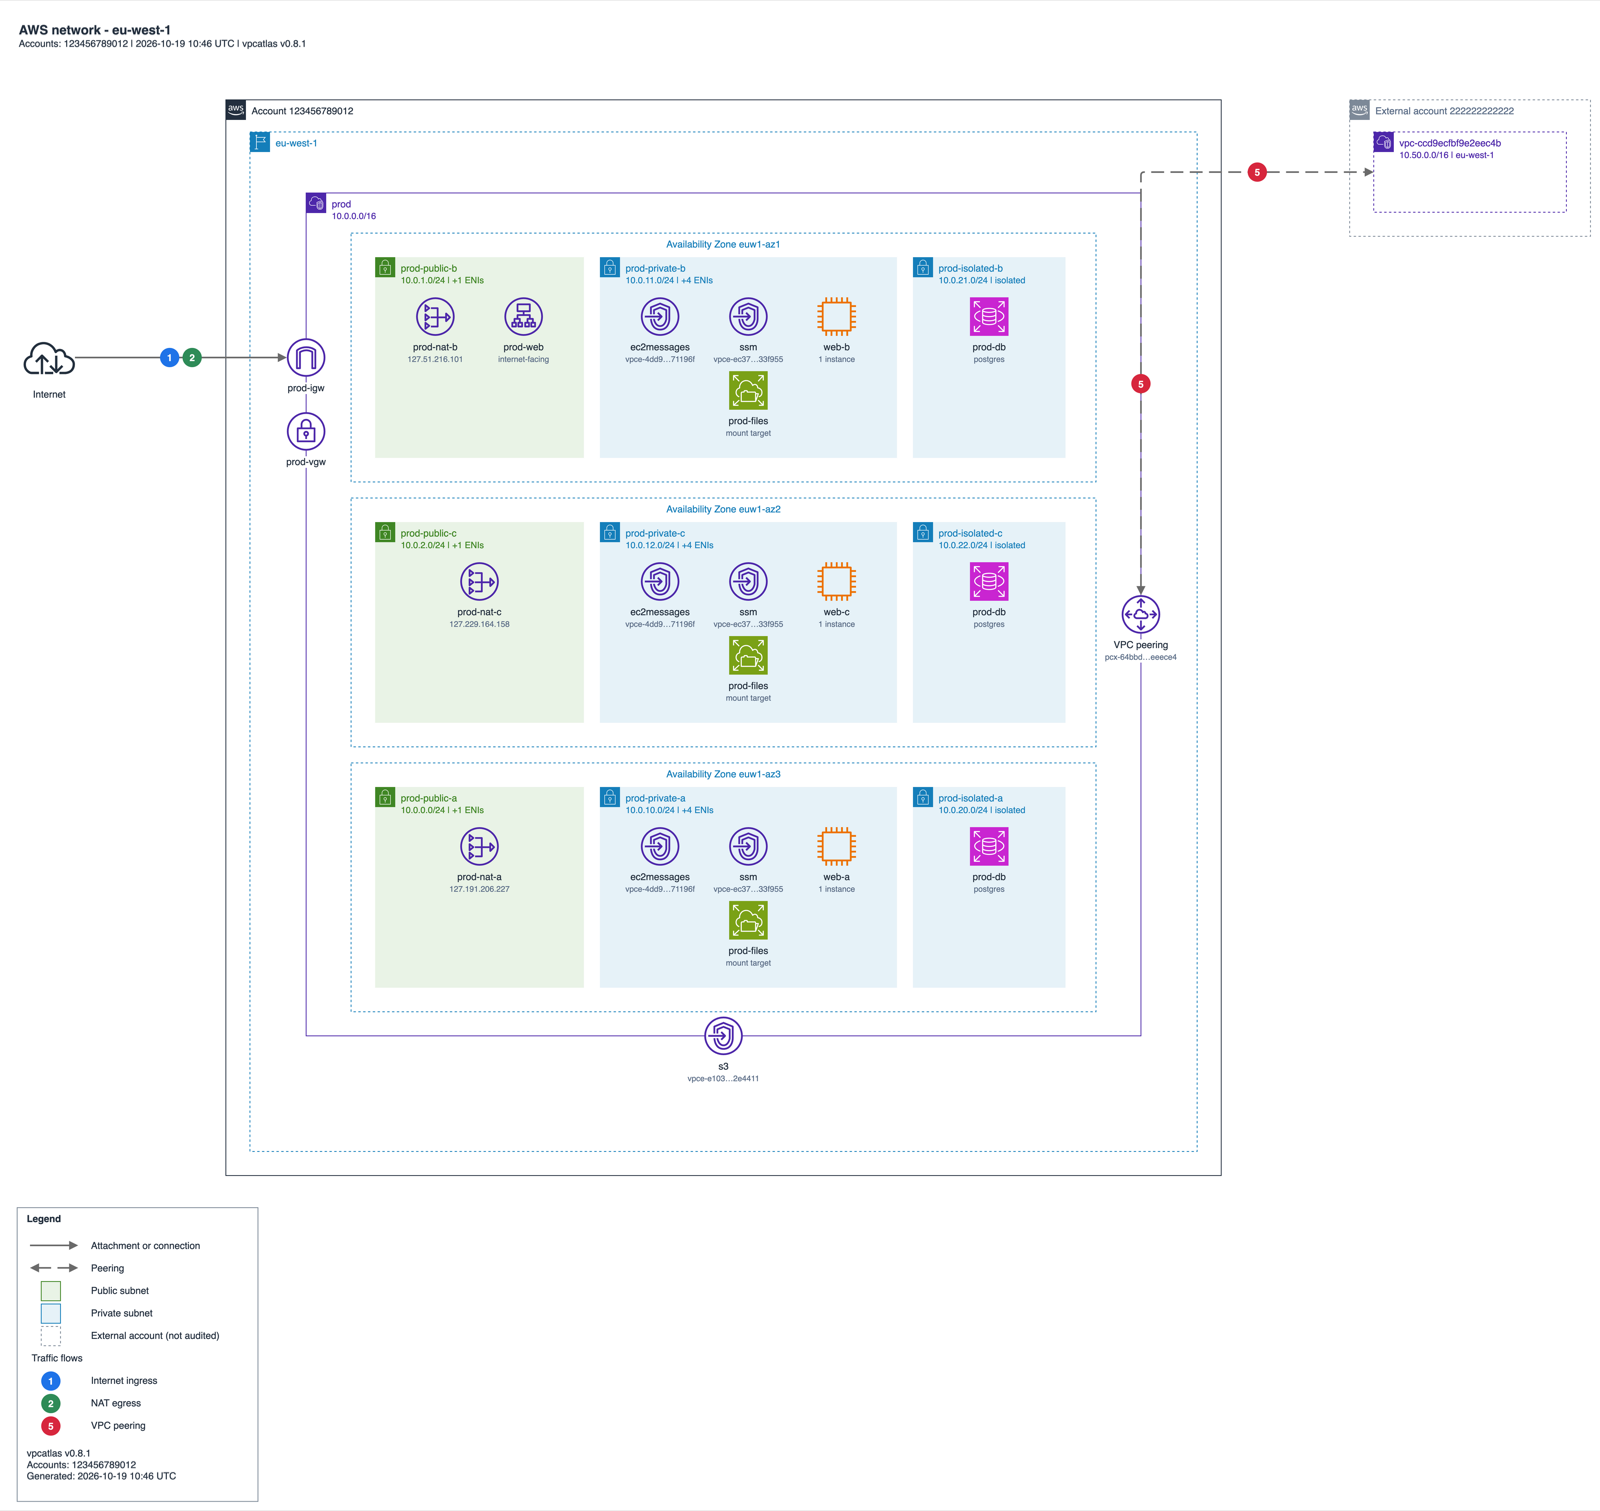
--tag Environment=prod: 34 de los 100 recursos, todos con Environment=prod, más el marco del que cuelgan.El peering está porque lleva Environment=prod él mismo; el dibujo lo cuelga de la VPC prod. La ejecución filtrada imprime un aviso, y quería que lo hiciera: «Working from a partial graph: only resources matching Environment=prod are kept (--tag).»
Conservar el marco
La forma obvia de filtrar es tirar todo lo que no coincide. Pero un NAT gateway sin subnet, sin VPC y sin región no tiene dónde ponerse, y no se puede dibujar. Así que un recurso que se queda conserva su marco: su cuenta, su región, y la VPC y las subnets de las que cuelga. Una subnet que coincide trae consigo su VPC, tenga tag o no.
La dirección contraria también pedía una decisión, y elegí la más estricta. Una VPC que coincide no arrastra sus subnets ni sus cargas de trabajo; tienen que coincidir por sí mismas. Si una VPC lleva Environment=prod y una de sus subnets Environment=staging, la subnet de staging se queda fuera del diagrama de prod, salvo que dentro haya algo con tag prod: entonces vuelve como marco de ese recurso. Prefiero un diagrama demasiado pequeño a uno que incluya staging sin avisar, que es justo lo que esta opción quiere evitar.
Los grupos de instancias que desaparecieron
VPC Atlas no dibuja las instancias EC2 una a una. Las dibuja en grupos: por Auto Scaling group, por Name o por subnet. Había que decidir qué tags lleva un grupo. En la 0.8.0 un grupo solo tenía su tag Name, o los tags de su Auto Scaling group.
Lo descubrí preparando las figuras de este artículo. Lancé --tag Environment=prod contra la cuenta simulada esperando la VPC prod con sus tres instancias, y las instancias no estaban: 3 de 3 grupos fuera. Las instancias llevan Environment=prod; los grupos no, porque un grupo solo tenía su nombre. El filtro hizo lo que yo había escrito, y lo que yo había escrito tiraba todo grupo de instancias cuyos tags estaban en las instancias y no en su nombre ni en su Auto Scaling group.
El arreglo está en la 0.8.1, publicada el mismo día. Ahora un grupo lleva los tags que todos sus miembros comparten con el mismo valor, más los del propio Auto Scaling group y su Name. Un tag que solo tienen algunos miembros no va en el grupo, porque no puedo llamar prod a un grupo si una de sus instancias no lo es. Con la 0.8.1 los tres grupos han vuelto, y la segunda figura se dibujó con esa versión. Si ejecutaste --tag con la 0.8.0 en una cuenta con instancias, vuelve a escanear con la 0.8.1: un fichero de grafo guardado con la 0.8.0 conserva los tags antiguos de los grupos, y --cache no los recupera.
Lo que desaparece, y por qué
De los 100 recursos, 66 quedan fuera. Quince están en tipos que se conservan en parte: 2 de 3 VPC, 5 de 14 subnets, 4 de 9 tablas de rutas y 4 de 7 security groups (5 de los 15 llevan Environment=shared y los otros 10 no llevan ningún tag). Los otros 51 son de 24 tipos que desaparecen por completo, y se reparten en tres grupos.
El grupo más grande son recursos que no llevan tag Environment en esta cuenta, así que el filtro hace bien en descartarlos: los servicios de edge (CloudFront, la hosted zone, el certificado, Shield), CloudTrail, Config y GuardDuty, el Transit Gateway con sus attachments y su tabla de rutas, la VPN y el customer gateway, 19 interfaces de red, 3 ACL de red y 6 listas de prefijos. Son huecos en el etiquetado de la cuenta. Por eso prod-vgw en la segunda figura acaba en el borde de la VPC: su conexión VPN no lleva tag. Un rótulo como +4 ENIs en la cabecera de una subnet es solo un contador que lleva la propia subnet; las interfaces en sí han desaparecido. El filtro solo muestra esos huecos como una ausencia; para listarlos, escribe el CSV con y sin --tag y compara la columna id.
Después vienen los servicios cuyos colectores no registran ningún tag: S3 y DynamoDB, y también WAFv2 (la web ACL) y Route 53 Resolver (los endpoints y la regla). La herramienta no puede saber si alguno lleva tag, así que ninguno coincide. Los stubs (recursos de otras cuentas a los que se refiere la tuya) y los resúmenes de cuenta están en la misma situación, aunque ninguno está entre estos 100.
El último grupo es un límite de la propia opción. Dos recursos están etiquetados Environment=prod en AWS y aun así desaparecen: la Lambda prod-api y el clúster de ElastiCache prod-cache. Sus colectores todavía no leen tags. Así que un diagrama de prod hecho con --tag no tiene una función ni una caché que cualquiera del equipo llamaría prod. El clúster de ECS prod y su servicio prod-worker también desaparecen, pero en esta cuenta no llevan tag Environment (el clúster solo tiene Name), así que no sirven para enseñar este hueco. La página de cobertura recoge este hueco de la herramienta. Mientras esos colectores no lean tags, trata el diagrama como la red etiquetada y revisa a mano esos servicios.
Caché, dashboard y una regla sobre el fichero
Un escaneo con --tag guarda el grafo reducido y anota las reglas en sus metadatos. Una ejecución posterior con --cache sobre ese fichero imprime el aviso de grafo parcial y nombra las reglas, para que medio grafo no pase por uno entero. Una ejecución con --cache y --tag reduce el grafo cargado de la misma manera y deja el fichero como estaba. La consecuencia práctica: si quieres prod hoy y el sandbox mañana, escanea una vez sin --tag y filtra el grafo guardado cada vez. Escanea con --tag solo cuando quieras el fichero reducido.
El dashboard toma las mismas reglas de --tag en vpcatlas serve, o de la variable VPCATLAS_TAGS, separadas por comas, por ejemplo Environment=prod,Owner. Un valor que contenga una coma necesita la línea de comandos. /api/status lista las reglas activas en filters.tags. Docker Compose pasa VPCATLAS_TAGS tal cual, y el chart de Helm acepta config.tags como lista. Con eso es posible un dashboard por entorno con las mismas credenciales, cada uno arrancado con su propia VPCATLAS_TAGS. El resto está en la documentación del dashboard.
Lo que no hace
- Filtra solo por tags. Una subnet sin tag se queda fuera del diagrama de prod aunque todas las de al lado entren, salvo que contenga un recurso que coincida.
- No puede usar los tags que los colectores no leen: por ahora, los de Lambda, ECS, ElastiCache, WAFv2, Route 53 Resolver, S3 y DynamoDB. Los tags salen de las mismas llamadas describe que los colectores ya hacen. La API de Resource Groups Tagging cubriría el resto en una sola llamada; todavía no está conectada.
- No hay modo que ignore mayúsculas, así que dos grafías de un mismo entorno son dos entornos.
- Reduce el grafo después del escaneo. El escaneo sigue leyendo toda la cuenta con los mismos permisos, así que
--tages una vista, no un límite. - Los 66 recursos que quedaron fuera son lo que pierde esta cuenta simulada; en la tuya serán otros.
Dime qué falta
La opción está en la documentación del CLI, el historial de versiones en el changelog, y el código en el repositorio y en PyPI. Si trabajas con una cuenta compartida, me gustaría saber qué tag usas de verdad para repartirla, y si un AND de reglas CLAVE=VALOR te basta o necesitabas un OR. Dime qué servicio buscaste en un diagrama filtrado y no encontraste, para que lea sus tags a continuación. Y si te serviría que la salida dijera qué recursos dejó fuera el filtro, y si cada uno no tenía tag o está en un servicio cuyos tags todavía no leo, dímelo; hoy no lo dice.